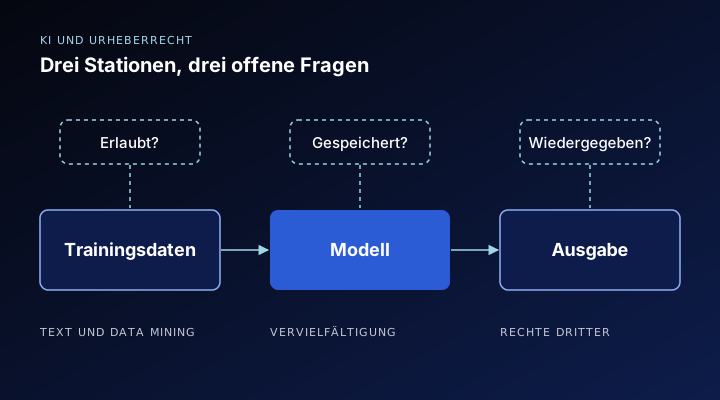
Am 3. November 2026 hat Generalanwalt Maciej Szpunar seine Schlussanträge im ersten Verfahren zu generativer KI vor dem Gerichtshof der Europäischen Union vorgelegt. Es geht um die Frage, ob ein KI-Chatbot die Rechte von Presseverlagen verletzt, wenn er Artikel aus dem Netz abruft und in seinen Antworten verwendet. Für Unternehmen stellt sich die Frage nach dem KI-Urheberrecht an zwei Stellen: bei den Daten, mit denen ein Werkzeug arbeitet, und bei den Inhalten, die es erzeugt. Der Beitrag fasst den Stand der Rechtsprechung zusammen und zeigt, was Sie im Betrieb regeln sollten.
Was der Generalanwalt zu KI und Urheberrecht vorschlägt
Im Verfahren C-250/25 klagt der ungarische Portalbetreiber Like Company gegen Google wegen des Chatbots Gemini. Der Chatbot ruft über ein Verfahren namens Retrieval-Augmented Generation aktuelle Inhalte aus dem Netz ab, darunter Presseartikel. Nach Auffassung des Generalanwalts kann das Recht des Presseverlegers in bestimmten Fällen verletzt sein. Entscheidend seien zwei Punkte: ob der Chatbot den Artikel unrechtmäßig abgerufen hat, etwa durch Umgehen einer Bezahlschranke, und ob die Antwort nur Fakten wiedergibt oder die konkrete Formulierung so erkennbar übernimmt, dass der Leser das Original nicht mehr aufrufen muss.
Zum Training von Sprachmodellen schlägt der Generalanwalt vor, die Vorlagefragen als unzulässig abzuweisen, weil nicht belegt sei, dass die Artikel überhaupt zum Training verwendet wurden. Der Vollständigkeit halber merkt er an, dass das Training mit geschützten Werken in der Regel unter die Ausnahme für Text und Data Mining falle. Schlussanträge binden den Gerichtshof nicht, das Urteil folgt später.
Wie deutsche Gerichte bisher entschieden haben
Das Landgericht München I hat am 11. November 2025 im Streit zwischen der GEMA und zwei Gesellschaften der OpenAI-Gruppe entschieden. Nach dem Urteil waren Liedtexte in den Modellen gespeichert und reproduzierbar. Das Gericht wertete das als Vervielfältigung, auch wenn die Texte nur in Wahrscheinlichkeitswerten in den Modellparametern stecken. Die Ausnahme für Text und Data Mining decke das nicht, weil sie die Vorbereitung einer Analyse erlaubt, nicht das Festhalten ganzer Werke im Modell. Auch die Wiedergabe der Texte in den Antworten verletze Verwertungsrechte, verantwortlich seien die Betreiber der Modelle. Das Urteil ist nicht rechtskräftig.
Im Fall des Fotografen Robert Kneschke gegen den Verein LAION hatten Landgericht und Oberlandesgericht Hamburg die Klage abgewiesen. Das Oberlandesgericht sah die Vervielfältigung eines Fotos für einen Trainingsdatensatz als von den Ausnahmen für Text und Data Mining gedeckt an, auch weil der Nutzungsvorbehalt der Bildagentur nicht nachweislich maschinenlesbar war. Der Bundesgerichtshof hat im September 2026 verhandelt und europarechtlichen Klärungsbedarf erkennen lassen. Wann er entscheidet, war nach der Verhandlung offen.
Zusammen zeigen die Verfahren eine Linie, die sich vorerst abzeichnet: Das Sammeln und Auswerten von Daten für das Training wird eher von den Ausnahmen für Text und Data Mining gedeckt. Kritisch wird es, wenn ein Modell geschützte Werke speichert oder in seinen Antworten erkennbar wiedergibt. Endgültig klären werden das erst der Gerichtshof der Europäischen Union und der Bundesgerichtshof.
Trainingsdaten und eigene Dokumente: Was § 44b UrhG erlaubt
Die meisten Unternehmen trainieren keine eigenen Modelle. Viele verbinden aber ein Sprachmodell mit eigenen Handbüchern, Verträgen oder Wissensdatenbanken oder lassen Werkzeuge Inhalte aus dem Netz auswerten. Hier gilt § 44b UrhG: Rechtmäßig zugängliche Werke dürfen für Text und Data Mining vervielfältigt werden, die Kopien sind zu löschen, wenn sie nicht mehr gebraucht werden. Hat sich der Rechteinhaber die Nutzung vorbehalten, ist sie nicht erlaubt. Bei online zugänglichen Werken wirkt ein solcher Vorbehalt nur, wenn er maschinenlesbar ist.
Für Anbieter großer KI-Modelle verlangt Artikel 53 der KI-Verordnung zusätzlich eine Strategie zur Einhaltung des Urheberrechts, die solche Vorbehalte erkennt und beachtet, sowie eine öffentliche Zusammenfassung der Trainingsinhalte. Diese Pflichten treffen die Modellanbieter. Für Sie als Nutzer zählt, was der Anbieter dazu vertraglich zusagt. Manche Anbieter sichern Geschäftskunden zu, Eingaben nicht für das Training zu verwenden, oder übernehmen unter Bedingungen die Verteidigung gegen Urheberrechtsansprüche. Solche Zusagen stehen meist in den Geschäftsbedingungen für Unternehmenskunden und gelten oft nicht für kostenlose Konten.
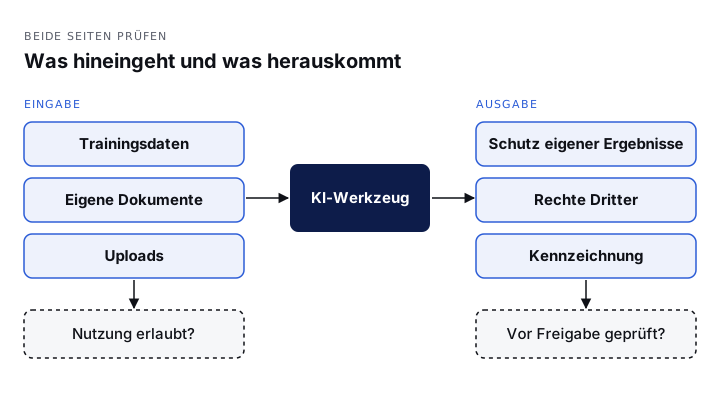
Urheberrecht betrifft beide Seiten eines KI-Werkzeugs: was hineingeht und was herauskommt.
KI-Urheberrecht bei generierten Inhalten
Nach § 2 Absatz 2 UrhG sind Werke nur persönliche geistige Schöpfungen. Ein Text oder Bild, das ein KI-Werkzeug ohne nennenswerten menschlichen Gestaltungsanteil erzeugt, ist deshalb in der Regel nicht urheberrechtlich geschützt. Wer Ergebnisse überarbeitet, auswählt und zusammenstellt, kann einen eigenen Schutz begründen; wo die Grenze liegt, ist im Einzelfall zu prüfen. Für Unternehmen heißt das: Konkurrenten dürfen rein KI-erzeugte Inhalte unter Umständen übernehmen.
Umgekehrt können KI-Ausgaben fremde Werke enthalten, wie das Münchner Urteil zu Liedtexten zeigt. Wer Texte, Bilder oder Code aus einem KI-Werkzeug veröffentlicht, sollte sie deshalb vorher prüfen, besonders bei Marketingtexten, Produktbildern und Programmcode. Dazu kommen die Kennzeichnungspflichten der KI-Verordnung für bestimmte KI-erzeugte Inhalte, die unsere Schwesterseite zur KI-Kennzeichnungspflicht erklärt. Eine Kennzeichnung klärt allerdings keine Rechtsfrage: Ein als KI-erzeugt markiertes Bild kann trotzdem fremde Rechte verletzen.
Was Unternehmen beim KI-Urheberrecht jetzt regeln
Bis der Gerichtshof und der Bundesgerichtshof entschieden haben, bleibt vieles offen. Einige Punkte können Sie unabhängig davon klären:
- Werkzeuge erfassen. Welche KI-Werkzeuge erzeugen Inhalte, die nach außen gehen, und welche greifen auf fremde Quellen zu?
- Anbieterverträge prüfen. Was sagt der Anbieter zu Trainingsdaten, zur Nutzung Ihrer Eingaben und zur Haftung bei Rechtsverletzungen?
- Uploads regeln. Fremde Texte, Bilder und Studien nur in KI-Werkzeuge laden, wenn die Nutzung erlaubt ist.
- Vor Veröffentlichung prüfen. KI-Ergebnisse vor der Freigabe auf übernommene Passagen und fremde Marken kontrollieren.
- Eigene Inhalte schützen. Wenn Sie nicht möchten, dass Ihre Website für Text und Data Mining genutzt wird, den Vorbehalt maschinenlesbar erklären.
Diese Regeln gehören in eine KI-Richtlinie. Die Grundlage dafür ist ein Überblick, welche Werkzeuge im Einsatz sind und welche Pflichten an jedem hängen. Ein KI-Audit liefert dieses Inventar samt Fahrplan und zeigt, wo beim KI-Urheberrecht in Ihrem Unternehmen Handlungsbedarf besteht. Einen ersten Überblick erhalten Sie im kostenlosen Erstgespräch. Konkrete Rechtsfragen sollten Sie im Einzelfall prüfen lassen.
Mehr dazu: KI-Audit
Kostenloser ReportKI DSGVO ReportPflichten als KI-Anwender im ÜberblickSichern →Quellen
- Schlussanträge des Generalanwalts in der Rechtssache C-250/25 Like Company, Pressemitteilung Nr. 155/26 (03.11.2026), Gerichtshof der Europäischen Union
- GEMA gegen OpenAI, Pressemitteilung 11/2025 (11.11.2025), Landgericht München I
- Geklaut für die KI? BGH verhandelt über KI-Training mit Fotos (03.09.2026), beck-aktuell
- § 44b UrhG, Text und Data Mining, Bundesministerium der Justiz
- § 2 UrhG, Geschützte Werke, Bundesministerium der Justiz
- Artikel 53 KI-Verordnung: Pflichten für Anbieter von KI-Modellen mit allgemeinem Verwendungszweck, AI Act Explorer